ゲーミング PC に GPU 5 枚。
ローカル LLM 実行環境
サーバー用パーツはゼロ。ゲームにも使う普通の自作 PC に、スロットとライザーケーブルを総動員して GPU を 5 枚ぶっこみ、VRAM 80GB にしました。AutoDev LG のローカル LLM は、全部この 1 台で動いています。
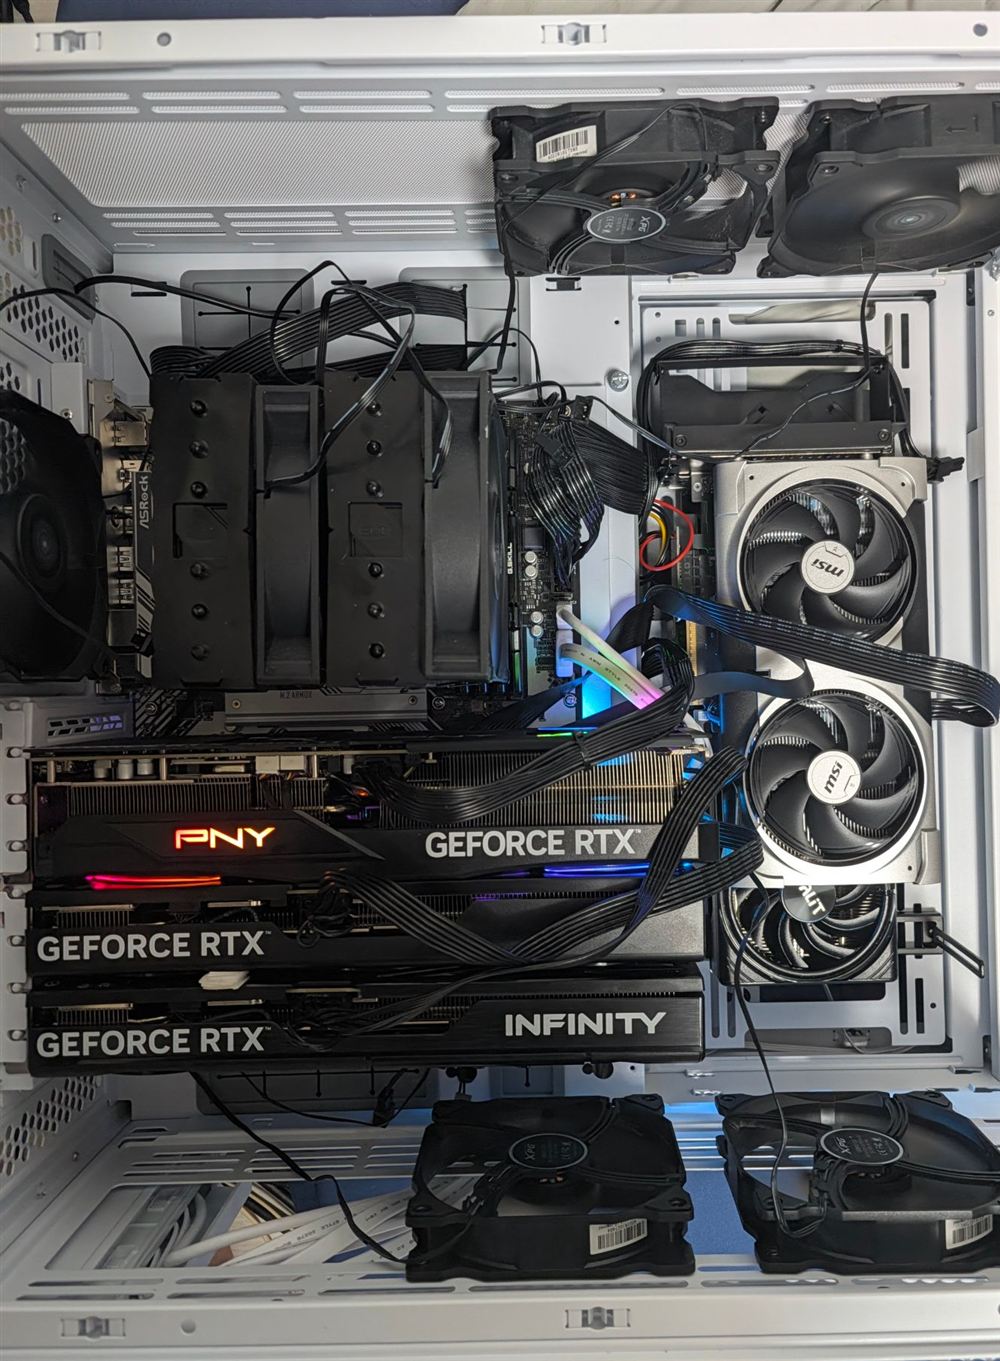
配線の美しさについては、見なかったことにしてください。
01ハードウェア
| パーツ | 中身 | ひとこと |
|---|---|---|
| CPU | Intel Core i9-14900KF(24 コア / 32 スレッド) | ゲーム用に買ったもの。32 スレッドすべてを WSL から使用 |
| メモリ | 128 GB(DDR4 32 GB × 4) | WSL にはその約半分(62 GB)を割り当て |
| マザーボード | ASRock B760 Pro RS/D4 WiFi | 普通のゲーミング向け。サーバー用には手が出ない |
| ケース | LIAN LI O11D EVO XL | GPU 5 枚を収めるために交換。届いてでかさにびっくり |
| GPU ブラケット | LIAN LI O11DEXL-1X(O11D EVO XL 専用オプションの VGA 垂直配置ブラケット) | ライザーケーブルでつないだ GPU を設置するために使用 |
| 電源 | Thermaltake TOUGHPOWER GT 1200W(ATX 3.1、PS-TPT-1200FNFAGJ-3) | GPU 5 枚の電力上限の合計は 1,020 W。ただ実際は、フル稼働時でも消費電力は 750 W に収まっている |
| ストレージ | NVMe SSD 2 TB × 2 + USB HDD 6 TB | モデルは NVMe に置く(USB だと読み込みがかなり遅い) |
| ネットワーク | I-O DATA ET10G-US3C(USB Type-C 接続の 10 ギガビット LAN アダプター、Realtek チップ) | GPU で PCIe スロットが埋まり、10G NIC を挿す場所がなくなったので USB 接続に。このマザーボードで唯一 10Gb/s 出る前面の USB 3.2 Gen2 Type-C ポートに挿して、リンク速度は 10 Gbps |
02GPU 5 枚の中身
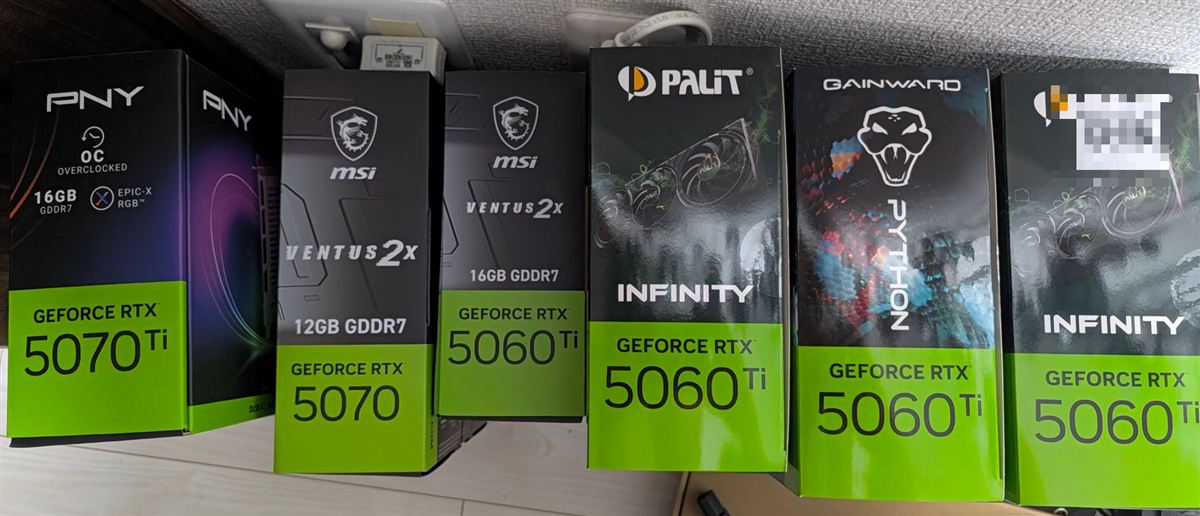
1 か月ちょっとでこの箱の数。どうかしてる。
……あ、5070 余ってる……。
PCIe スロットに直挿しできたのは 3 枚。足りない 2 枚はライザーケーブルでつないでいます(PCIE2 と M.2 スロットの M2_2)。その結果、接続の太さが 1 枚ずつバラバラです。
| GPU | スロット | VRAM | 電力上限 | 接続(実測) |
|---|---|---|---|---|
| RTX 5070 Ti | PCIE1 | 16 GB | 300 W | x16 直挿し |
| RTX 5060 Ti ① | PCIE2 | 16 GB | 180 W | x1 ライザー |
| RTX 5060 Ti ② | PCIE4 | 16 GB | 180 W | x1 直挿し |
| RTX 5060 Ti ③ | PCIE3 | 16 GB | 180 W | x4 直挿し |
| RTX 5060 Ti ④ | M2_2 | 16 GB | 180 W | x2 ライザー(M.2 変換) |
RTX 5060 Ti 4 枚のメーカーは MSI(VENTUS 2X)、Palit(INFINITY)× 2、GAINWARD(PYTHON)。統一感はゼロです。
「接続」は NVIDIA のドライバーが報告した、今のレーン数です。GPU 5 枚の電力上限を足すと 1,020 W になります。
どのスロットに、どの GPU?
マザーボードの配置図とブロック図を元に、Windows が認識している PCI の位置と、実際の接続の太さを突き合わせました。帯の長さがレーン数(x1〜x16)です。
スロット名は ASRock B760 Pro RS/D4 WiFi のマニュアルの表記です。
MoE モデルなら動きます(Dense モデルについては下の「04」で)。AutoDev LG では、1 つのモデルを層ごとに 5 枚へ分けて載せています(llama.cpp の「層分割」)。この方式だと、生成中に GPU 同士がやり取りするのは層の境目の小さなデータだけなので、細い接続でもそれなりに走ります。細さが効いてくるのは、主にモデルを読み込むときです。
ただし、tensor parallelism には要注意。1 つの層を複数の GPU で分担する方式なので、GPU 同士がひっきりなしにデータをやり取りし、この構成では性能がまったく出ません。こんな奇特な構成をとる人は少ないと思いますが、ご注意を。
03ソフトウェア
| 層 | 使っているもの | メモ |
|---|---|---|
| OS | Windows 11 Pro + WSL2(Ubuntu 24.04.5 LTS) | Windows ネイティブ版も試したが、長い文脈で遅く WSL に戻した |
| GPU まわり | NVIDIA ドライバー 617.14 / CUDA 13.3 | |
| 推論エンジン | llama.cpp 公式版(build 11151)+ Unsloth 版(build 11160) | Unsloth 版は Qwen3.8-Flash-Next の MTP 用。ほかのモデルは公式版 |
| 言語 | Python 3.12 | AutoDev LG 本体は Python で書かれている |
| ワークフロー | LangGraph 1.2 | 工程の順番と分岐(失敗したらどこへ戻るか)を管理 |
| AI エージェント | OpenHands SDK 1.46 | オープンソースの自律型 AI 開発エージェント基盤。ワーカー役のローカル LLM が、これを通してファイルの編集やコマンドの実行を行う |
04使っているモデル
モデルは 1 つずつ、5 枚の GPU にまたがって載せます。役割が替わるたびに入れ替えるので、そのたびに数十 GB を読み込みます。
| モデル | 構造 | 役割 | 量子化・サイズ | 高速化(MTP など) |
|---|---|---|---|---|
| Qwen3.8-Flash-Next | MoE | リーダー/ワーカー | AP-Q4_K_XL・95 GB | MTP ヘッド(別ファイル・Q8_0・3.9 GB) |
| Qwen3.8-27B | Dense | テストコード作成 | UD-Q4_K_M・16 GB | MTP(モデル内蔵) |
| Gemma-4-26B-A4B-it | MoE(26B のうち約 4B が稼働) | レビュアー | BF16・48 GB | MTP 用の補助モデル(Q8_0・0.4 GB) |
| gpt-oss-120b | MoE | 予備 | MXFP4・60 GB | EAGLE3(Q8_0・0.8 GB)※ |
この環境で Dense モデル(1 トークンごとに全部の重みを使うモデル)を複数の GPU に分けて載せると、性能が出ません。ボトルネックは PCIe の帯域。x1・x2 の細い接続や、5 枚中 4 枚がチップセット経由で共有している DMI Gen4 x4 が詰まってしまいます。
MoE(Mixture of Experts)モデルなら、総パラメータは大きくても、1 トークンごとに働くのは一部の「専門家」だけ。たとえば Gemma-4-26B-A4B-it は、26B のうち毎回使うのは約 4B(名前の「A4B」)です。
というわけで、ここで動かしているのは Qwen3.8-Flash-Next・Gemma-4-26B-A4B-it・gpt-oss-120b と、MoE ばかり。Dense モデルは、GPU 1 枚の VRAM(16 GB)に収まる場合だけ使うことにしています。唯一の Dense モデルの Qwen3.8-27B も、そのルールに収まるサイズです(さらに MTP で速度を底上げ)。VRAM 80 GB と聞いて「大きな Dense モデルも動くのでは?」と思った方、残念ながらこれは MoE 専用機です。
Dense:1 トークンを出すたびに、モデルのすべての重みを使う構造。昔からある一般的な形です。
MoE(Mixture of Experts):モデルの中に多数の「専門家(エキスパート)」を持ち、1 トークンごとにその一部だけを使う構造。総パラメータは大きくても、1 回に動かす量は小さく済みます。
MTP(Multi-Token Prediction、複数トークン予測):次の 1 トークンだけでなく数トークン先まで予測し、本体のモデルがまとめて答え合わせする高速化の仕組み。答え合わせをするので、出力の中身は変わりません。
※ gpt-oss-120b は MTP 用の層を持たないため、同じ考え方の別方式「EAGLE3」の補助モデルを後付けしています。
文脈の長さは 65,536 トークン。KV キャッシュは 4bit(q4_0)に圧縮し、Flash Attention を有効にしています。高速化の効果はチューニング記録にまとめています。
05ついでに
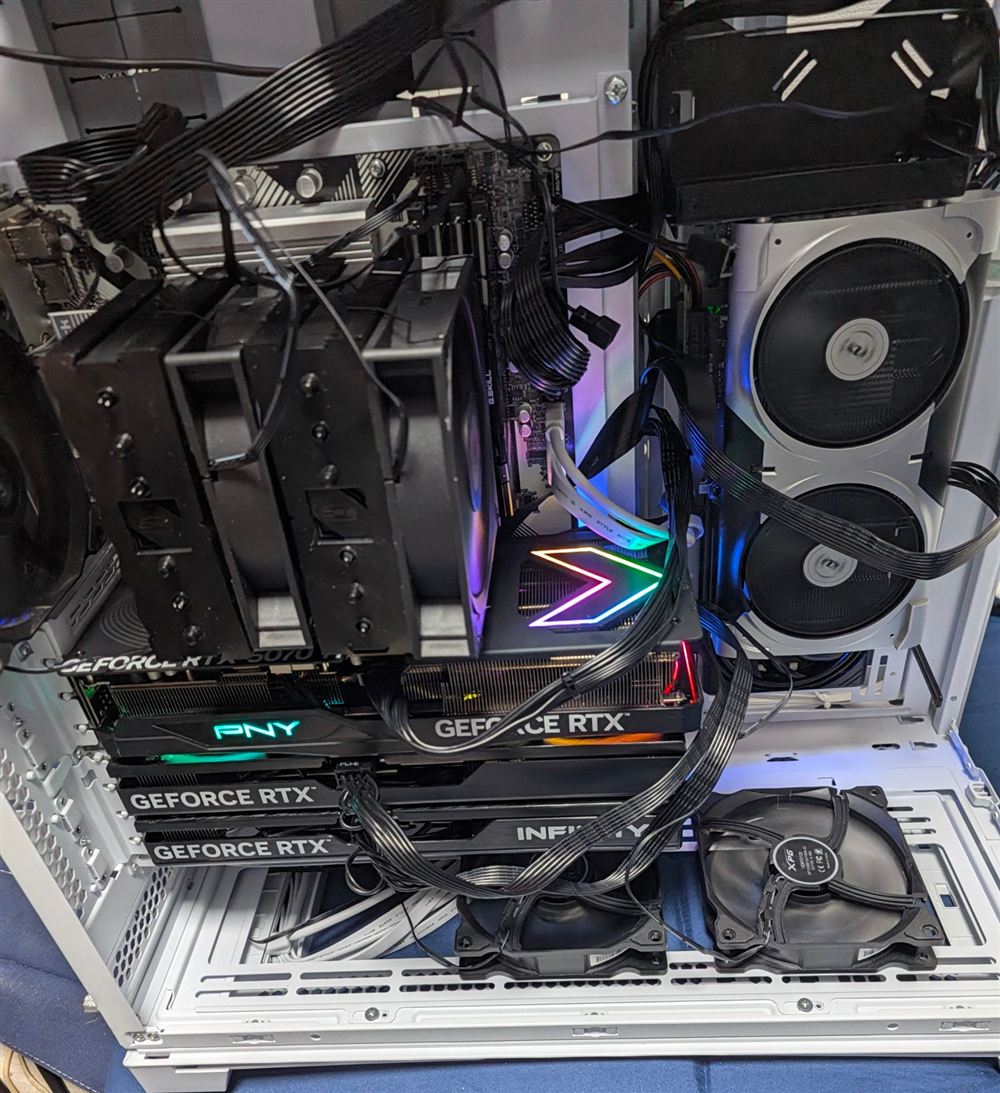
M6 Mac mini(最小構成)も 1 台あります。「いずれ iPhone アプリも作るから」と自分に言い聞かせて買いました。……今のところ出番なし(笑)。
GPU の購入費用がどこまで回収できたか(もし Claude API で動かしていたら?)は、開発ログの回収メーターで毎日更新しています。
開発ログを見る →仕組みを見る →