GPU 購入費用回収メーター もし Claude API で動かしていたら?
これまでのローカル LLM の消費トークン:入力 1.5 億 / 出力 1,068 万 → Claude Opus 5.5 なら約 $685(約 102,700 円)
1 枚目の RTX 5060 Ti、あと約 7,300 円で元が取れる!
※ ローカル LLM が使ったトークンを Claude API(Opus 5.5・定価)で払っていたらいくらか、の累計と GPU の購入額を比べています。GPU は試算用に RTX 5060 Ti 11 万円・RTX 5070 Ti 16 万円、回収は 5060 Ti から順に数えています。電気代は含みません。
アプリ開発の実行結果
デプロイ前のテスト件数の推移(AuteDev の規模の目安)
日々の記録
※ API 換算は定価・キャッシュ実測値込み・1 ドル 150 円。Claude はトークンの数え方が違うため、実際は最大 1.35 倍ほど高くなることがあります。電気代は含みません。
10/24(土)
invader-radar の画面直しと素材づくりが一気に進み、GLM を2台目のマシンでも動かせるようにした日。 作る側の道具も、地道に太くなりました。
- アプリの側では、ゲーム画面の下のボタンの並び(ヒント・決定・音・タイトルに戻る)を整える直し(CR-1144)と、駒のポーズ違い 18 枚、ルール説明用の図 7 枚が main に入りました。タイトル画面の直し(CR-1147)や、戻す・やり直すボタンの位置の直し(CR-1145)は、テストを流している最中です。
- 道具の側では、2台目のマシンの V100 で GLM(Maya)が動くようになり、1台目が埋まっているときは2台目に仕事を回す振り分けも本線に入りました(AD-0185)。同じ日に、Qwen3.8-27B と Qwen3.5-9B で「スマホの画面を機械に見せて確かめる」下見も行い、8 件中 6 件を読み取れました(字の読みやすさは苦手)。
- つまずきは、駒を4つのポーズからランダムに描く直し(CR-1148)。対象のファイルが大きすぎて、実装役の出力の目安を超えて止まりました。直し方は AuteDev 側で調べているところです。次にやることは、止まった直しの再開と、DeepSeek-V4.1-Flash の大きなモデルのダウンロードを最後まで終えることです。
10/23(金)
invader-radar を GitHub に引っ越し、クラウドの助っ人にも初めて仕事を頼んだ日。 一方で、メインの PC が一度止まるアクシデントもありました。
- アプリの側では、吹き出しとチュートリアルの枠を音のボタンの左までに狭める直し(CR-1135)が main に入りました。ソースはプライベートの GitHub にも写し、スマホ(Pixel)には製品版と同じ署名のデバッグ版を上書きで入れて、人の目で確かめてもらいました。
- 確かめて見つかった指摘(吹き出しが透けて読みにくい、字が枠に対して小さい、操作の説明が消える、音のボタンの文字がそろっていない、駒を置いた数字が見づらい)は 5 つの直しにまとめ、クラウドのセッションに頼みました。結果は次の日に確かめます。
- つまずきは、メインの PC が一度停止したこと。そのうえ大きなモデルの測定が同じ PC を長く使うため、テストの全件実行と取り込みは待ち状態です。次は、PC が使えるようになりしだい、クラウドの直しをテストに通し、スマホ用の画面で見た目を確かめてから main に取り込むことです。
10/22(木)
invader-radar が「ブラッシュアップ」に腰を据え、署名つきの製品版 APK まで作れるようになった日。 サーバー連携はいったん脇に置いて、スマホで遊んで見つかった細かい点を直していきました。
- アプリの側では、次の面を裏で先に作っておく仕組み(CR-1125・1126)、画面の安全な領域に収める直し(1128・1129)、効果音を計算で作った音に差し替える変更、ライセンス表示の追加が main に入りました。パッケージ名も
com.autedev.invaderradarに決まり、リリース用の鍵で署名した製品版の APK をスマホに入れて動作を確かめました。 - つまずきというより、気づきが多かった日です。「数字のあるマスの × が見づらい」「ヒントの後の決定ボタンはいらない」「ロゴの上の空白がもったいない」など、実機で見つかった指摘が CR-1130〜1133 になり、CR の作成が順番に流れています。
- AuteDev 本体にも改修 164〜181 が入り、依頼文を詳しくする新しい役の試運転や、例外を土台側の設定だけに絞る強化が済みました。次は、この 4 本の CR を検査に通して main に取り込むことです。
10/21(水)
invader-radar が「サーバーとお話しする準備」を着々と整えた日。 端末だけに保存していた記録を、将来クラウドにも送れるように、小さな変更を 7 つ重ねました。
- アプリの側では、送る順番を決める部品(CR-1111)、通信の結果を受ける口(1112)、トークンの取り直し(1113)、設定があるときだけクラウドの口を使う切り替え(1114)、インターネットの許可と空の設定ファイル(1116)、起動時にサーバーを読む処理(1115)、ゲーム開始時に読んで画面を更新する処理(1117)が次々と main に入りました。設定の値はまだ空なので、アプリは今までどおり端末だけに保存します。
- つまずいたのは、送るときにベストの記録が消えてしまう穴をふさぐ CR-1118 です。テストを作る役が、補助の関数の戻りの型を間違えて、検査に 2 回止められました。依頼に「型は付けない」と書き足して 3 本目を流しています。
- 検査の側では、AuteDev 本体に改修 164〜172 と 175 が入り、依頼の文から CR の一部を機械が写せるようになりました。次は CR-1118 を通して Firebase の CR をそろえることと、アプリ側の許可の表を入れることです。
10/20(火)
invader-radar の見た目がぐっと整い、AuteDev 本線は v1.132 まで進んだ日。 表の角が丸くなり、説明のタイルが点滅し、ヒントも日本語になりました。
- アプリの側では、CR-1087b・1088・1086d・1080a・1089・1091・1092b・1093 が次々と取り込まれました(上の数字を表に、表の余白と線、チュートリアルの説明をタイルで、表の角を丸く、説明のタイルだけ点滅、チュートリアル中はヒントを押せない、ヒントの文を日本語に)。ロゴの素材も入り、表の上にロゴを置く CR-1090 とクリアのタイルをピンクにする CR-1095 は取り込みの判断待ちです。
- つまずいたのは、「遊び方」ボタンを「説明」に変える CR-1094 です。CR を作る役が、依頼の 1 行目の言葉を CR に写せなかったり、「最初の行に足す」を別の変更と同じ行にまとめてしまったりして、検査に止められました。止めてくれたのは検査が効いている証拠なので、依頼の書き方を直して作り直します。
- 検査の側では、CR を写すときに式・条件・順番が落ちる穴をふさぐ改修が 4 つ入り、本線は autedev-v1.132 になりました。次は、端末の保存(CR-1080b〜1082)の続きと、「説明」ボタンの CR-1094 を通すことです。
10/19(月)
検査の改修が 33 回入り、invader-radar にも新しい面の作り方が入った日。 AuteDev 本線は autedev-v1.80 から v1.112 まで進みました。
- アプリの側では、invader-radar の CR-1062(起動のときに 11 面から先を作らず、縞の仮の面を置く)が取り込まれ、テストは 416 件すべて通りました。
- 検査の側では、依頼の範囲の行を機械で 1 項目に写す、依頼の YAML の checks を機械で CR に写す、今のコードでも成り立つ項目を LLM を呼ぶ前に止める(C67)、同じ式に食い違う期待値が並ぶテストを止める、などを入れました。緩める変更は承認をもらってから、強める変更は自走で入れています。
- CR を作る役は V100 と Maya の両方で作って見比べる形に。12 組の時点では「Maya だけ OK」が 2、「V100 だけ OK」が 1、「両方 NG」が 9 と、まだ難しい題が多いです。30 組たまったら振り分けを見直します。対応表の監査は影の運用中で、20 件ほどたまったら既定にするかを決めます。
10/18(日)
AuteDev 本体の「検査」をひたすら磨いた一日。 本線は autedev-v1.43 から v1.79 まで、37 回の改修を取り込みました。
- 磨いた中身: CR(変更依頼書)の確かめる項目が「今すでに成り立つこと」や「画面からはみ出す矩形」を見逃さないように、止める検査(C44〜C54 など)を次々に足しました。作り直しが前の案を写さず組み直したときに止める検査、禁止された API を使うテストを止める検査も入りました。誤検出を直す変更は、そのつど承認をもらってから入れています。
- 仕組みの面でも前進: CR の書式
fieldsを選べる形で入れ、対応表の監査(CR を作る役の見逃しを機械で拾う検査)も、まず既定オフで本線に入れました。 - 次にやること: 取り込んだ改修をまだ本番の run で確かめていないものが多いので、次の run の結果を見るたびに台帳を埋めていきます。
10/17(土)
AuteDev 本体の改修を一気に進め、「何を直したか」を台帳に残す仕組みもできた日。 改修 24〜31 を本線に取り込み、本線は autedev-v1.24 になりました。どれも判断の一覧でユーザーが承認してから入れています。
- 取り込んだ改修: 起動の確かめ(スモーク)、作り直しを理由どおりに行う検査、多言語対応のための文言の表(5 列)、アプリの撮影スクリプトの終わり方、テーマの上書き、部品を足す・動かす CR だけに絞った検査、そして検査の誤検出を 2 件直す変更。検査を絞る・緩める変更は、誤検出を直すものでも必ず承認をもらう決まりにしました。どの改修がいつ入ったかは、新しい「改修の台帳」に番号とタグ付きで並びます(まだ本番の run で確かめていない改修は 13 件。次の run の結果を見るたびに確かめていきます)。
- 試した結果の記録も。NVIDIA の FP4 版 Qwen3.8-Flash-Next は動きましたが、CR を作る役としては 11 件中 9 件で、時間は 2.4 倍。V100 の 8 件とほぼ同じ型の誤りが出たので採用せず、止めました。多言語対応は、設計の方向(第 1 段の小改修まで)が決まり、アプリの基盤づくりに入る前にユーザーへ「使う言語・翻訳を誰が作るか」を聞く段取りです。
- 次にやること: 作り直しで参考の CR の項目が理由なく消える失敗の型(T-az)と、「直す」理由のときの比べ方(T-aw の続き)を直す改修 32 の候補。invader-radar の CR-1039 は、ユーザーが実機で確かめる段階(R3')で待っています。
10/16(金)
改修 run を 10 本流して 5 本が pushed、そのうち 3 件が invader-radar の main に入った、これまでで一番にぎやかな日。CR を作る役は GLM-5.3-Flash(Maya)が基本になった。 テスト作成役と実装役は 2 台目 PC の V100 の Qwen3.8-Flash-Next のままです。
- 取り込まれた 3 件: CR-1029(右下の惑星をルールの文と重ならない所へ、v0.28)、CR-1030(起動画面の背景をゲームらしい画像に、v0.29)、CR-1026(起動画面で選んだ言語を本編の HUD と吹き出しに渡す、v0.30)。どれもユーザーが Pixel で遊んで確かめてから main に入りました。CR-1026 は 3 回目でようやく pushed。1 回目はテストが「中身のない実装でも通ってしまう」と検査に止められ、2 回目は実装役が言語の値を渡しそびれて「English」のまま。3 回目で日本語の HUD が実機に出ました。うれしい! 起動画面の背景は、ローカルの画像生成(FLUX.2 klein 4B)で作った絵を素材として入れたもので、絵を描く仕事も AuteDev の流れに乗りました。
- うまくいかなかった方も記録に。CR-1027(斜めも隣り合えないと分かる丁寧なチュートリアル)は、チュートリアルの段を 6 から 7 に増やしたことで過去の CR のテストが落ち、2 回直しても戻らず NOT PASS。CR-1032(ゲーム画面に「タイトルに戻る」ボタン)は pushed になったものの、ユーザーが実機で見ると左下のボタンがピンクの惑星と重なって見つけにくく、「機能したが、デザインと位置を直したい」と取り込まずに作り直しへ。背景の飾りを「避ける物」に入れていなかった、という新しい失敗の型が見つかりました。CR-1033(効果音と音楽)は、音を作るモデルで素材を用意したのに、CR を作る役が素材を知らずに波形をコードで作ろうとして NG。素材や見本の絵を CR を作る役に渡せる「添付」の仕組みをその場で足しました。
- AuteDev 本体はこの日だけで改修 5〜20 が進み、失敗の型の一覧も T-a から T-ap まで増えました。Maya は 1 件 14〜42 分(Qwen3.8-Flash-Next は 1〜3 分)と重いので、易しい依頼は V100 を先に試し、難しい依頼と作り直しは Maya に、という振り分けに。ハーネスの取り込みも「承認済みの方針の中・検査を弱めない・テスト全通過・退行なし・前の版にすぐ戻せる」などの条件を満たせば自走してよいことになりました。次は、CR-1032 のボタンをヒントのボタンの右隣に置き直すこと、画像生成で作った見本(ユーザーが選んだ C 案)を添付して「すべての画面のボタンをかわいいタイル調に」する CR-1034、そして CR-1033 の音の作り直しです。
10/15(木)
改修 run が本番に戻ってきた日。起動画面の依頼が 1 日で pushed になり、ユーザーが実機で起動を確かめた。そして「Claude は CR を直さない、直すのは AuteDev の側」という新しい決まりが生まれた。 基準の組み合わせ B0(CR を作る役・テスト作成役・実装役の 3 役とも、2 台目 PC の V100 で動く Qwen3.8-Flash-Next)で、まず過去の 2 件を流し直してから新しい依頼に進みました。
- 流し直しは 1 勝 1 敗。CR-1024(かわいい宇宙の背景)は前回とほぼ同じ速さで pushed。CR-1022(パステル調の盤)は、実装役が「塗りつぶす」と「線の太さ」を同時に指定して Godot に怒られ、関係ない既存のテスト 3 件を巻き込んで NOT PASS。同じ CR でも通ったり通らなかったりする「実装の揺れ」です。新しい依頼の CR-1025(タイトルと言語の選択、選んだ言語で「チュートリアルから始める」「すぐに始める」の 2 つのボタン)は、1 回目は Claude が CR をほぼ書き直したうえに(約 60 行)、その中のフォントの指定がテストの環境で動かず失敗。指定を外した 2 回目で pushed になり、main に取り込んで(v0.26)、ユーザーが Pixel で起動画面を確かめました。続く CR-1028(上に手数を出す)も pushed で、Pixel で見て取り込み(v0.27)。やっと本番の流れが 1 本つながった!
- ここで方針転換。ローカル LLM の書いた CR の誤りを Claude が直すのをやめ、正しい CR を出せるように AuteDev(CR を作る役のハーネス)を直すことにしました。この日のうちに改修 1〜4 を入れ、評価の依頼で CR が出た割合は 6/11 から 10/10 に。あわせて GLM-5.3-Flash(Maya)に CR を作る役を試させると、所要は 343 秒(Qwen3.8-Flash-Next は 41 秒)と遅いものの、中身は「変えること/変えないこと」が一貫して依頼の言葉どおりで、目で見て明らかに良い CR でした。
- 外部のレビュー(Fable)の方針 J1〜J7 をすべて採用。「完了」の定義は、新しい CR 10 件連続で Claude の介入 0・push 7 件以上を 2 回。判断待ちの一覧を見るダッシュボードもこの日にでき、チャットも「AuteDev 本体の改修」「invader-radar の CR を流す」「ダッシュボード」の 3 本に分けました。次は、日本語対応・斜めのチュートリアル・惑星の位置の 3 件を、新しい決まりで流します。
10/11(日)
新しい道の第一歩。ローカル LLM が Godot のコードを書き換えて、INVADERS のキャラクターをドット絵にできた! 改修の仕組みを作り込む前に、まず「そもそもローカル LLM に GDScript の改修が書けるのか」を手作業で確かめました。
- 試したのは Qwen3.8-27B と Qwen3.8-Flash-Next(Strata)の 2 つ。仕事は「ドット絵のデータを新しいファイルに書く」と「描画の部分をドット絵を貼る形に差し替える」の 2 回に分けました。どちらのモデルも、エラーを見せて直させるのは 2 回までという条件の中で合格し、既存のテスト 83 件も全部通りました。所要は Qwen3.8-27B が 87 秒、Qwen3.8-Flash-Next が 144 秒です。
- つまずいたのは、別ファイルを読み込む 1 行の書き忘れや、Godot では定数にできない書き方など、うっかり系のミスでした。古い Godot 3 の書き方が紛れ込むことはありませんでした。画面のない環境でもスクリーンショットが撮れることを確かめたので、出来上がりを目で見て確かめられます。Qwen3.8-Flash-Next 版は元どおり行ごとに色分けされ、Qwen3.8-27B 版はインベーダーが暗い赤や茶色になりました。
- まだ各モデル 1 回ずつの結果なので、安定して書けるかはこれから。次は、この流れを自動で回す「改修 run」の最小版を作ります。
10/10(土)
🧮 ローカル LLM の消費トークン:入力 210 万 / 出力 18 万 → Claude Opus 5.5 なら約 $12(約 1,800 円)
Claude の助けなしで走る本番の練習が始まり、その結果を受けて AuteDev の進む道を大きく切り替えた日。 まず held-out 3(初めて見せる題材)の inv129 が 40 分で PASS。そのあと v257 で「run の中では Claude を一切使わない」決まりに切り替えると、INVADERS・taskboard・held-out 3 の 3 本はどれも NOT PASS でした。補助輪を外した最初の日の転び方としては上々で、転んだ場所はしっかり記録に残っています。
- v257 では、run の中で Claude がどの役にも入れないように門を作り、ローカル LLM が進まなくなったら「どこで・どんな入力で詰まったか」を丸ごと保存するようにしました。詰まった記録はあとで Claude の手本と比べて、教師データにする計画です。
- inv130(INVADERS、88 分)は、受け入れテストの作り直しで行き詰まりました。テストが本題の操作にたどり着く前の「下準備の確認」で落ちていたのに、直す側は期待値の数字を直そうとして空回りしていました。v258 でこの落ち方を機械で見分け、作り直す側に正しく伝えるようにしました。inv131(taskboard、74 分)では、テストがエラーの小窓を閉じる手当てをしないまま削除ボタンを押し、小窓が開いたまま 60 秒待って時間切れに。v259 では、止まった場所を記録して「小窓を開いたまま」を見分けるようにし、決められていない種類の例外を出した実装には、規約どおりの例外を明記して直しを頼むようにしました。inv132(held-out 3、23 分)は、テストを書く段の検査に通らず止まりました。
- ここで大きな方針転換。 ローカル LLM だけの 3 本が完走しなかったことを受けて、AuteDev は「仕様書からアプリをゼロで作る」道具から、「git に置いたアプリを、依頼 1 件ずつ改修し続ける」道具に生まれ変わることになりました。題材はスマホでも動くよう、tkinter をやめて Godot(GDScript)版の INVADERS に。最初の依頼は「キャラクターの絵をドット絵にする」です。AuteDev がするのはブランチに届けるところまでで、本流に取り込むかは人が実機で遊んで決めます。さっそく AuteDev 自身と INVADERS を git に登録し、毎日の控えも取り始めました。
10/09(金)
PASS が 5 回も! 昨日までの苦労はこの日のためにあった。
🧮 ローカル LLM の消費トークン:入力 220 万 / 出力 34 万 → Claude Opus 5.5 なら約 $17(約 2,500 円)
INVADERS が 9 回続けて PASS。しかも最後の inv128 は 22 分で、これまでで一番の速さ。 午前の inv125 に続き、夜までに inv126・inv127・inv128 も PASS(所要は 36 分・26 分・22 分)。そのうえで「設計のやり直し」を減らす作戦も試した一日でした。
- inv125 は止まらずに通りましたが、分析すると、設計の 1 回目が毎回同じ指摘で突き返され、やり直しに 1 回あたり約 6 分かかっていることが分かりました。v251 では、その指摘をあらかじめ最初の指示の最後に「最終チェック」として書き添え、テストを書く段にも同じように、検査でよく引っかかる点を先に伝えるようにしました。
- ところが、設計役(Qwen3.8-27B)だけで試すと、最終チェックの一部は無視され、言い方を変えた v252 でも設計のやり直しは 2 回のまま減りませんでした。決めておいたルールどおり、v253 で設計役への追加の指示は元に戻しました。うまくいかなかった作戦は潔く引っ込める、これも大事な一歩です。一方で、正しく直したテストを検査が誤って落としていた件(v252)や、テストを書く段への最終チェックはそのまま残しています。
- 夜は「人が手で直さなくても機械的に直せる指摘」を片づける改修が続きました。v254 では、テスト計画の指摘のうち機械的に直せる 2 種類を、設計役とのやり直しの往復なしで自動で直すようにし、やり直しの指示も狭めて、直さなくていい項目まで書き直す無駄を減らしました。v255 では、実装役が「受け入れテスト全件合格」に達した時点でそこで止める仕組みを入れました(狙いは時短より、結果のばらつきを減らして再現性を上げること)。v256 では、検査が「描画は状態を変えない」という正しいテストを取り違えて何度も差し戻していた誤検出を直しました。
- 次は、inv129 の結果を見ながら、v255 の「途中で止める」副作用(細かい端の場合の取りこぼし)が出ていないかを見守り、run を続けます。
10/08(木)
4 回 PASS の大漁日! フレームワーク、ちゃんと育ってる。
🧮 ローカル LLM の消費トークン:入力 260 万 / 出力 40 万 → Claude Opus 5.5 なら約 $20(約 3,000 円)
run を 5 回まわして 5 回とも PASS! 前日の PASS がまぐれではなかったと分かった一日。 INVADERS で 3 回(inv120・inv122・inv123)、開発中に一度も見せていない未見のお題で 2 回(inv121・inv124)、どれもアプリが最後まで緑で通りました。
- 結果は inv120 が 26/26(43 分)、inv121 が 28/28(52 分)、inv122 が 33/33、inv123 が 30/30(41 分)、inv124 が 19/19(40 分)。未見のお題は 2 つとも初めて見る種類のアプリでしたが、ちゃんと PASS。うれしい連勝です! 止まりはしなかったものの、inv122 では 2 つの実装が同じテストで別々の値を出して食い違い、テストの作り直しに 8 分半を空費していました。v249 では、こういうときは作り直す前に「本来どの値が正しいか」を設計役に先に決めてもらうようにしました。
- 裏では、テストを書く役をローカルの LLM(Gemma-4-26B-A4B-it など)に任せる試験もしました。こちらは苦戦。書いたテストが、正しく動くはずのアプリでも 17 件中 5 件落ちるという「テストの方が間違っている」状態でした。そこで v247 と v250 で、正しいアプリを落としてしまうテストの書き方を見つける検査を足し(v250 だけで 8 種類)、v248 ではテストをまとめて 1 回で書かせず、小分けにして書かせる仕組みを入れました。
- 次は、この連続 PASS を保ちながら、毎回のように出ている「1 回目の設計がやり直しになる」ぶんの時間を減らすことです。
10/07(水)
今日は 3 回も PASS! 笑いが止まらない。
🧮 ローカル LLM の消費トークン:入力 1,852 万 / 出力 201 万 → Claude Opus 5.5 なら約 $122(約 18,300 円)
設計の確認まわりの「つまずきポイント」をひとつずつつぶし、夜にはついに未見のお題の run が PASS した一日。 開発中に一度も見せていない新しいお題(作り手が答えを知らない、いわば抜き打ち試験)で試す run が続き、止まった場所を v232〜v245 の 14 版で次々に直しました。
- 止まり方はいろいろでした。設計の根拠を足したら元の根拠が消えて失敗(inv104→v232)、テストの追加分が別のクラスに入ってしまって動かない(inv106→v233)、アプリが返した値があとから書き換わってしまうのをテストが見逃す(inv107→v234)、設計の確認で参照する範囲が食い違う(inv108→v235)。午後には、テストに書く「期待する値」が SPEC にも API規約にも書かれていない(v242)、テストを縛るルール同士が引っ張り合う(v243)、関門が誤読した偽の指摘(v244)で、アプリ作りの手前(
test_invalid)で止まる run がありました(inv114・inv116・inv117)。 - 原因は run のたびに分析して、一つずつ改修しました。v236 では、関数どうしの食い違いやプロンプトの例の間違いを、版を出すたびに自動で調べる検査を新設。v237〜v239 では、設計の関門が見つけた誤りを隠さず全部報告するようにしました。v240 は Claude Code 用の設定の余計な長さ制限、v241 は Godot 向けの作り直しの収束を直しました。v243・v244 では、関門を甘くせずに「誤読だけ」を取り除いています。
- そして夜、うれしい結果が出ました。inv115 はアプリ作りまで緑で通り(agent_build_green)、inv119 は未見のお題で 40/40 の PASS。所要は 97 分でしたが、そのうち約 54 分は結果を変えない作業だったので、v245 で無駄な作り直しと修復の周回を省く改修を入れました。やっと報われた! 次は、この PASS を連続でも再現できるかを確かめます。
10/06(火)
PASS が 4 回も! 昨日までの苦労はこの日のためにあった。
🧮 ローカル LLM の消費トークン:入力 925 万 / 出力 102 万 → Claude Opus 5.5 なら約 $59(約 8,800 円)
テストを書く側が追いつかない日、そして「Claude を仲間に入れる」決断の日。 夜明け前から日中にかけて、アプリ作りに進む前にテストの段階で止まる run が続きました。それでも inv98・inv99・inv102・inv104 では、アプリ作りまで緑で通る run が戻ってきました。
- 前日の終わりに足した「テストを厳しくする関門」が重すぎて、ローカルのモデルがテストを書ききれず、アプリ作りの手前(
test_invalid)で止まる run が続きました(inv94・inv96・inv100・inv101)。「偽のタグで SPEC を確かめたことにする」抜け道をふさぐ改修(v226)や、テストの前提ミスを機械で見つける仕組み(v229)を入れました。 - 大きな方針転換が 2 つありました。v228 で、どの役割でも Claude Code(
claude -p)を使えるように切り替えられる仕組みを導入し、Claude を「ローカルモデルが目指す見本」として同じ SPEC・同じテストで動かせるようにしました。v230 では、アプリを作る側のモデルが自分の run の受け入れテストを覗けないように、隔離された空間(jail)の中で動かす改修を入れました。過去の run を調べて、のぞき見が起きていないか確かめたうえでの決定です。 - 夜は inv103(約 3 時間)が、設計の確認プロンプトがモデルの文脈の長さを超えてしまい停止。v231 で確認を小分けにして余裕をもたせました。次は、この設計の確認まわりの安定が課題です。
10/05(月)
INVADERS (インベーダー) で 3 回連続 PASS 達成!! 目標クリア、思わず声が出た。
🧮 ローカル LLM の消費トークン:入力 1,054 万 / 出力 114 万 → Claude Opus 5.5 なら約 $65(約 9,800 円)
INVADERS、PASS! 21 件のテストが全部通りました。やっと報われた! 日付をまたいで走り続けた inv81〜inv87 の末に、inv87 が緑のバッジに届きました。そして夜には inv90・inv91・inv92 が 3 回続けて PASS。うれしい一日になりました!
- 前日の終わりから、残るテストは「画面の文字を読むテスト」と「保存に失敗する場面を作るテスト」の 2 種類でした。v215〜v219 では、弾・爆弾・保存失敗のテストを機械的に直す手順を足しました。結果は 17/21 → 20/21 → 20/21 → 19/21 と、あと 1 件のところで足踏みしました。
- 決め手は v220 です。「爆弾が毎回できてしまう」テストと「保存まで届かない」テストを、assert(確かめる行)は変えずに前の準備だけ足して直す手順(M1・M2)を入れました。inv87 は両方のアプリで 21/21、約 73 分で完走しました。
- 続く inv88 も 21/21 でした。ただ、よく調べると、書き直された画面のテストが「ゲームオーバーの文字」を実は確かめておらず、保存失敗のテストも肝心の値を見ていませんでした。そこで v221 で「書き直したテストが本当に変化を見ているか」を測る仕組みを、v222 で「テスト計画に書いた項目を必ず確かめる」決まりを入れました。inv89 は 20/21 で止まりましたが、v222 の inv90(20/20、約 114 分)・inv91(約 68 分)・inv92(約 85 分)は 3 回続けて緑です。
- 喜びつつ、穴さがしも進めました。PASS したアプリから 1 行を抜いたり文字を空にしたりしても、35〜40% はテストを通ってしまうことが分かりました。v223 でテストを厳しくする関門を 2 つ足したところ、inv93 は関門を越えられず約 35 分で停止(アプリ作りの手前)。v224 で、こうした「強くするための関門」だけでは run が止まらないように直しました。テストの中身が変わったので、連続 PASS の数え直しは v223 からです。次は inv94 で確かめます(この記録の時点では実行中です)。
10/04(日)
🧮 ローカル LLM の消費トークン:入力 1,255 万 / 出力 107 万 → Claude Opus 5.5 なら約 $74(約 11,100 円)
日付が変わってすぐ v202 の inv68 が 22 件中 19 件で NOT PASS になり、その後も 12 回続けて INVADERS を走らせた一日。どれも惜しいところで止まりましたが、17/18 まで詰めました。
- v202 は「1 つの版に 2 つの修正」を入れた最初の版です。1 つは、ある操作の説明が「出してよいエラーの種類」と食いちがっていたら設計係に差し戻すこと。もう 1 つは、書き直したテストを 1 件ずつ受け入れるようにしたこと。inv68 では 2 つのアプリ作りまでたどり着き、最後に残ったのは 3 件(弾がインベーダーに当たったときの動き、画面の描き方、ハイスコアの保存)。約 2 時間 5 分かかりました。
- その後は inv69〜inv80 を走らせ、毎回「テストのまちがいか、アプリのまちがいか」の見きわめで止まりました。残るのはたいてい、画面の文字を読むテストと、保存に失敗する場面を作るテスト。v203〜v214 の改修では、書き直したテストを両方のアプリで確かめる、実際に動いた値を書き直しの材料にする、古い画面表示を読むテストをはじくなどを入れました。
- 次は、残った「保存失敗」と「画面表示」の 2 種類のテストを、決まった手順で直せるようにします。
10/03(土)
taskboard で 3 回連続 PASS 達成!! 目標クリア、思わず声が出た。
🧮 ローカル LLM の消費トークン:入力 1,048 万 / 出力 93 万 → Claude Opus 5.5 なら約 $65(約 9,700 円)
INVADERS、2 回目の PASS! しかも今度は但し書きなし。 日付が変わってすぐ run の時間を縮める改修 v190 から始まった一日は、うれしい合格とたくさんの改修の日になりました。
- 前日の inv55 では、かかった時間の 6 割が、仕様に逆らうテストを相手にした修正のやり直しでした。v190 は動きは変えずに、そのムダを削る改修です。答えの出ない修正ラウンドは 20 分から 5 分で打ち切り、何も変わらないラウンドが続いたら早めに切り上げます。目標は INVADERS 1 回を 110 分以内。
- あわせて、v189 で入れた「ほかの値から決まる項目」の書き出しを、勝ち負けやゲームの状態のようなものだけに絞りました。inv56 で残りの命やスコアまで入れてしまい、テストを作れなくなった反省です。さらに、命の数などの「原因になる値」をセットする操作が API規約に無いときは、最初の段階で設計係にやり直してもらうようにしました。
- taskboard の 2 回目(invtb2)は、事前のチェック結果が古いと判定されて、始まる前に止まりました。v190 で走った inv57 は 17 件中 15 件で NOT PASS。答え合わせのやり直しは前日の 98 分から 33 分に縮みましたが、全体では約 2 時間 29 分。「原因になる値」をセットする操作が無いのに、チェックをすり抜けていました。別のクラスにたまたま同じ名前の引数があったのを数えてしまっていたのです。
- そこを直した v191 の inv58 で、INVADERS が 18 件すべて合格! かかった時間は 73 分で、目標の 110 分を楽々クリア。設計係が最初から「命の数をセットする」「インベーダーの並びをセットする」操作を用意し、2 つのアプリの共通の失敗(弾の動き)も、テストを書き換えずに 1 回の確認で解決しました。inv50 のような但し書きの付かない、文句なしの合格です。報われた! 続けて走らせた taskboard の 3 回目(invtb3)も 8 件すべて合格で、約 33 分の緑でした。
- ただ、そのあとは届きませんでした。inv59 は 12 件中 9 件、inv60・inv61 も NOT PASS。テストの前提がまちがっている(毎回動くインベーダーを止まっていると思い込む、など)ケースが残り、v192〜v201 で、テストの書き直しを両方のアプリで先に試す、LLM の分析役をやめて記録の事実だけを渡す、2 つの実装役がおたがいの作業場所をのぞけないようにする、といった改修を重ねました。inv62 は 30 件中 25 件、inv64 はテスト作りの段階で止まり、inv65 は 12 件中 9 件、inv66 は 12 件中 8 件。v202 の inv67 は設計の段階で同じ答えを 2 回くり返して止まりました。PASS は inv50 と inv58 の 2 本ですが、間に NOT PASS がはさまったので、目標の「3 回連続 PASS」はまだこれからです。
10/02(金)
2 回 PASS の大漁日! フレームワーク、ちゃんと育ってる。
🧮 ローカル LLM の消費トークン:入力 632 万 / 出力 52 万 → Claude Opus 5.5 なら約 $39(約 5,900 円)
taskboard に続いて、INVADERS も初めての PASS! エンジンを Strata に載せ替えた日に、いきなり報われました。
- 前の晩に走らせ始めた taskboard の run(v178)が、日付が変わってすぐに agent_build_green、つまり緑で完走しました。かかった時間は約 83 分。上流の仕様分析とテスト作りが約 20 分、既製エージェントによる 2 回の組み立てが 19 分と 10 分でした。案 B(アプリを作るのは既製のコーディングエージェントに任せ、AuteDev は仕様の分析・API規約・テスト作りと答え合わせに専念するやり方。アプリは 2 つ別々に作らせ、両方そろって落ちるテストは、テストか仕様の方を疑います。前日に採用)に切り替えて 1 日足らずで、いきなり 1 本目の合格です。うれしい!
- 途中はちゃんとヒヤッとしました。最初の採点は 11 件中 8 件と 7 件で、3 件が両方のアプリでそろって失敗。今回はテストの間違いではなく、2 つのアプリに共通する作りのミスでした。修正ラウンドを 1 回まわしたところで 11 件すべて合格。怪しいテストも残らず、文句なしの緑です。
- おまけの朗報として、作業環境を新しいところへ引っ越したあとでも、全体が最初から最後までちゃんと動くことを確かめられました。
- 使う LLM の顔ぶれが変わりました。 夜通し試していた推論エンジン「Strata」で Qwen3.8-Flash-Next を動かすと、指示を読む速さが約 5 倍に。しかも GPU 1 枚で済み、作り比べ 7 回の品質も落ちていませんでした。試しに INVADERS を走らせた inv49 は、前回より 37% 速く終わりました。そこで v180 から、リーダー役とアプリを作る役を Strata 版に正式に交代。さらに v184 からは、空いた GPU で Qwen3.8-27B が 2 つ目のアプリを同時に作るようになり、アプリ作りが 2 本立てで並んで走ります。
- そして交代直後の inv50(v180)で、INVADERS がついに PASS! 27 件のテストが全部通りました。これまでの INVADERS の run では、一度も届かなかったゴールです。決め手は、前日に入れた「○○の定義をお願いします」の仕組みでした。ゲームクリアやゲームオーバーを確かめるテストは、長々と遊ばないとその場面にたどり着けません。そこで「インベーダーの数」や「残りの命」を直接セットする操作を API規約に足してもらい、作り直したテストは 1 回で承認されました。目標の「3 回連続」の 1 本目として数えます(スコア表示の形をテストに合わせて決めた点と、終わりの場面をこの追加の操作で作っている点は、但し書き付き)。
- その後は一進一退です。inv51 は、テストの後片付けの書き方の誤りで、アプリに関係なく全部のテストが落ちる状態になり、途中で止めて検査を追加しました。inv52 は、端に来たインベーダーの位置が (18,2) か (19,2) かという決めごとが残って NOT PASS。2 つのアプリを同時に作るようにして最初の inv53 は、13 件すべて合格で一度は 2 本目の PASS と喜んだのですが、あとで見直すと、却下したはずの「状態を直接書き換える操作」が API規約に残っていて、片方のアプリはゲームオーバーのあとリスタートしても始まらない作りでした。テストがそこを確かめていなかっただけなので、2 本目には数えないことに。続く inv54 はテスト作りの段階で止まりました。
- 夜の inv55(v188)は 16 件中 14 件で NOT PASS。残った 2 件は「ゲームオーバーのあとでも進むはず」というテストで、仕様書では「ゲームオーバー後は何もしない」。2 つのアプリはどちらも仕様どおりで、テストの方が仕様に逆らっていました。しかも約 2 時間 43 分かかり、その 6 割は、直しようのないテストを相手にした修正のやり直しに消えていました。
- そこで v189 では、「勝ち負けやゲームの状態のような、ほかの値から決まる項目」を API規約に名前で書き出し、その項目を直接書き換える操作やテストは、LLM に判断させる前にプログラムではねる仕組みに。言葉のルールを LLM に足すたびに判断がぶれていた反省からです。最初に走らせた inv56 は、残りの命やスコアまで「ほかから決まる項目」に入れてしまい、テストを作る段階で止まりました(test_invalid)。
10/01(木)
やった! PASS きた! 画面の前で小さくガッツポーズ。
🧮 ローカル LLM の消費トークン:入力 689 万 / 出力 57 万 → Claude Opus 5.5 なら約 $38(約 5,800 円)
作戦変更の日。「作る」のは既製エージェントに任せる「案 B」へ舵を切りました。
- なぜ作戦を考え直したのか。 INVADERS はこれまで約 40 回走らせて PASS がゼロ。止まった理由を振り返ると、できあがったアプリの出来ではなく、AuteDev が途中で自分で作るもの(API規約の抜け、テストのバグなど)でつまずいていることがほとんどでした。前日には、既製のコーディングエージェント(OpenHands と Qwen3.8-Flash-Next)に AuteDev の仕様書と API規約を渡したら、19 分でほぼ同じ出来のアプリを作ってしまう、という比較結果も出ていました。
- そこで並べた選択肢が 2 つ。案 A は、今の工程のまま検証の精度を上げていく道。手間は少ないものの、穴をふさぐたびに新しい穴が見つかる「モグラ叩き」になりがちです。案 B は、アプリを作るのは既製エージェントに任せて、AuteDev は仕様の分析・API規約・テスト作り・検証に専念する道。どちらにするか決めるため、夜通し比較実験をしました。条件 a は、エージェントに仕様書と API規約を最初から渡す。条件 b は、仕様書だけで作らせて、あとから API規約に合わせさせる。b は「事前の設計図がなくても作れるのか」を確かめるためのものです。
- 朝に届いた結果は、はっきりしていました。条件 a は 3 回とも 16〜27 分で、正しいテスト 18 件のうち 17〜18 件が通りました。AuteDev 本体が約 3 時間かけて出した 18 件と、ほぼ同じ出来です。条件 b は 54〜61 分かかったうえに 0/14/16 件と安定せず、API規約という設計図の価値が数字で見えました。さらに「別々に作った複数のアプリがそろって落ちるテストは、テストの方を疑う」クロスチェックは、7 つの実装で既知のテストの間違い 4 件をすべて言い当て、濡れ衣はゼロでした。一方で、エージェントは失敗を直すのが苦手で、手が止まったり、同じエラーを 22 分直せなかったりしたので、直す段取りは AuteDev が受け持つことにしました。こうして、アプリを既製エージェントに2 回、別々に作らせて答え合わせする「案 B」に決まりました。なお、この日から Claude Fable 様はいったんお休みです。
- run は inv42〜inv48 の 7 回で、全部 NOT PASS。それでも中身は前進の連続でした。inv44 で初めて案 B の工程を最後まで通り、2 つのアプリはどちらも 24 件中 22 件合格。残る 2 件はテスト側の間違いで、「一発も撃たずに 500 回待てば全滅するはず」「動いているインベーダーの最初の位置めがけて撃つ」という、ちょっと無理のある答え合わせでした。ただし「怪しいテストが残ったまま」は合格に数えないと決め、怪しいテストを作り直す道をつなぎました。
- inv47 で見えてきたのは、もう一段深い原因です。怪しいテストの多くは、仕様書が決めていない値をテスト係と 2 つのアプリがそれぞれ違う解釈で埋めていたものでした。たとえば「最上段から 2 行目」は y=1 なのか y=2 なのか。どちらも悪くないので、テストを作り直しても決着しません。そこで v178 では、こういう値を上流に差し戻し、「○○の定義をお願いします」と具体的にお願いする仕組みを入れました。
- 最後の inv48 では、その定義のお願いが実戦で初めて動き、4 件すべてに答えが返ってきて API規約に書き足されました。ところが、それをもとにテストを作り直す係が全員却下されてしまい、合格には届かず。次の課題は「テストを作り直す係」の腕前です。夜は気分を変えて、taskboard を案 B で走らせ始めました。
09/30(水)
🧮 ローカル LLM の消費トークン:入力 3,999 万 / 出力 150 万 → Claude Opus 5.5 なら約 $102(約 15,300 円)
名前が変わった日。AutoDev LG → AuteDev(読み:アウテデブ)。
- きっかけは、ネットで見かけた解説記事。Microsoft が 2024 年に研究として発表した「AutoDev」が、コード生成からテスト、バグ修正まで自分でこなす AI エージェントとして紹介されていました。名前も、やろうとしていることもほぼ同じ。2 年半も前から、先客がいらっしゃいました。
- 救いの手は意外なところに。このサイトのドメイン autedev.com は、取得するときに AutoDev と打つつもりで o を e に打ち間違えたもの。調べてみると「AuteDev」を名乗るプロジェクトは見当たりません。ただの typo が、世界にひとつだけの名前に昇格しました。
- ついでに「LG」も外して、ドメインとぴったりそろえました。LG は骨組みに使っている LangGraph の頭文字で、バージョン番号の LG1.10.x にはこれからも残ります。これより前のノートは当時の記録なので、旧名のままにしてあります。
- そしてもうひとつ、ちょっとずるしました。 バグ直しがなかなか収束しないので、AuteDev 本体の修理役に、いつもの Claude Opus 5.5 に加えて Claude Fable 様を部分的にお招きしました。やっぱり賢い。いつもは 1 歩ずつしか進まないところを、3 歩まとめて進んでいく感じです。なお、アプリを作るのは相変わらずローカル LLM だけ。ずるをしたのは、あくまで「直す係」の話です。
- INVADERS の run はこの日だけで inv27〜inv40 の 14 回。結果は全部 NOT PASS でしたが、前進もありました。inv37 では、コーディング役が自分で書いたテストが初めて全部通り、これまでで一番奥まで進みました。つまずいたのは最後の関門で、答え合わせ用のテストが、アプリが実際に使うのとは別の部品を自分で作って確かめていた、というテスト側のうっかりです。
- そして夜、転換点かもしれない出来事。 既製のコーディングエージェントと同じ仕様書で作り比べてみたら、AuteDev の「作る」工程は、素のエージェントより優れていることを示せませんでした。しかも向こうは 1/6〜1/9 の時間で同じ結果。まだ 1 回だけの比較ですが、なかなかの衝撃です。
- Claude Fable 様の戦略レビューの結論は「作るのは既製エージェントに任せて、AuteDev は仕様の分析と検証に専念しては」。170 版かけて磨いてきたものの大半は、まさにその「検証する側」にあるので、無駄にはなりません。……と自分に言い聞かせています。ちなみに試しにやった「クロスチェック」(別々に作った 2 つのアプリの両方で落ちるテストは、テストの方を疑う)は、すでに分かっていた間違ったテスト 4 件をぴたりと 4 件とも言い当てました。
- 今夜は改修と run のループをいったん止めて、比較実験を夜通し回します(その直前に v170 で始めた inv41 が終わってから)。どちらへ進むかは、朝に結果を見て決めます。
09/29(火)
2 回 PASS の大漁日! フレームワーク、ちゃんと育ってる。
🧮 ローカル LLM の消費トークン:入力 3,060 万 / 出力 88 万 → Claude Opus 5.5 なら約 $65(約 9,800 円)
速さで勝った日。MTP を載せた構成で taskboard の loop68 が 54 分で PASS、さらに loop71 は 約 38 分で PASS して最速記録を更新! 苦労して積んだ高速化がやっと報われました。
- あいだの loop69・loop70 は NOT PASS。どちらもテストの書き方でつまずきました。1 つ目は、画面の部品の値を書き換えるだけで、ボタンを押したときの処理を動かしていなかったこと。2 つ目は、仕様にない種類のエラーを期待するテストを何度も書いてしまったこと。v144・v145 でそれぞれ直すと、loop71 がすんなり PASS。
- そのあと INVADERS に戻り、inv20〜inv26 まで挑みましたが、ここは全部 NOT PASS(inv24 は途中で止めて直しを優先)。つまずき方は毎回ちがいました。キー操作のテストを AutoDev LG 自身のチェックが誤って弾いたり(v148 で修正)、最初に決める設計図に「ハイスコアをどこに保存するか」が抜けていてコードとテストがかみ合わなかったり(v150 で設計図を点検する仕組みを追加)、コーディング役が自分で書いたテストに中身のない部品が混ざっていたり(v153・v154 で対応)。
- 最後の inv26 は、設計図から「画面を描く部分」が抜けてしまい、テストを書く段階で Qwen3.8-27B・Gemma-4-26B-A4B-it・gpt-oss-120b の 3 モデルとも合格できずに止まりました。v150 で設計図の形を変えたことの副作用です。次の直し方は方針を決めてから取りかかります。
モデルごとのチューニング内容と速度の変化は、記事「LLM チューニング記録」に表でまとめました。
09/28(月)
人生初の PASS!! ローカル LLM が本当にアプリを最後まで作りきった……! 何度もログを見返してしまう。
🧮 ローカル LLM の消費トークン:入力 181 万 / 出力 10 万 → Claude Opus 5.5 なら約 $7(約 1,000 円)
WSL が消えるトラブルから立て直した一日。Windows ネイティブ版(v134/135)も作りましたが、長いコンテキストで llama-server が遅く、WSL に戻しました。
- 再構築した WSL で taskboard の loop67 が PASS(1 時間 19 分)。環境の作り直しは成功。
- INVADERS の inv18 は NOT PASS。テストコード生成で 3 モデルとも
test_invalidになり、コーディングまで進めず。いまの弱点は Test 段階。 - v141 で MTP(投機的デコード)を試験導入し、速度計測へ。
09/27(日)
寄り道の日。YouTube で Hermes Agent の紹介動画を見つけ、「これだ!」と飛びつきました。
- ……が、ローカル LLM で動かしてみると、まるで使い物にならず。夢は数時間で終了。
- 結論:一日ムダにした。 おとなしく AutoDev LG の開発に戻ります。
- ちなみに人間が浮気している間も、ローカル LLM たちは文句ひとつ言わず、黙々と 9 回挑戦していました。えらい。
09/22(火)
開発の合間に、なぜか Mac mini をお買い上げ。「将来は iPhone アプリも作るから必要」と自分に言い聞かせて。……今のところ出番なし(笑)。
はじまりの記録
2026-07-30(木)
すべての始まり。「ローカル LLM でバイブコーディングしてみたい!」——ただし、自分でコードを書く能力も時間もない。そこで閃いた作戦がこちら。
- 安いと評判の DeepSeek に 2 ドルだけ課金し、「ローカル LLM にコマンドラインで簡単な処理をさせるプログラム」を作るアプリを作らせる。AI に、AI を働かせるアプリを作らせる。(ややこしい)
- 相棒の GPU はまだ RTX 5070(12GB)1 枚。いまの 5 枚体制から見ると、ずいぶん身軽な旅立ちでした。
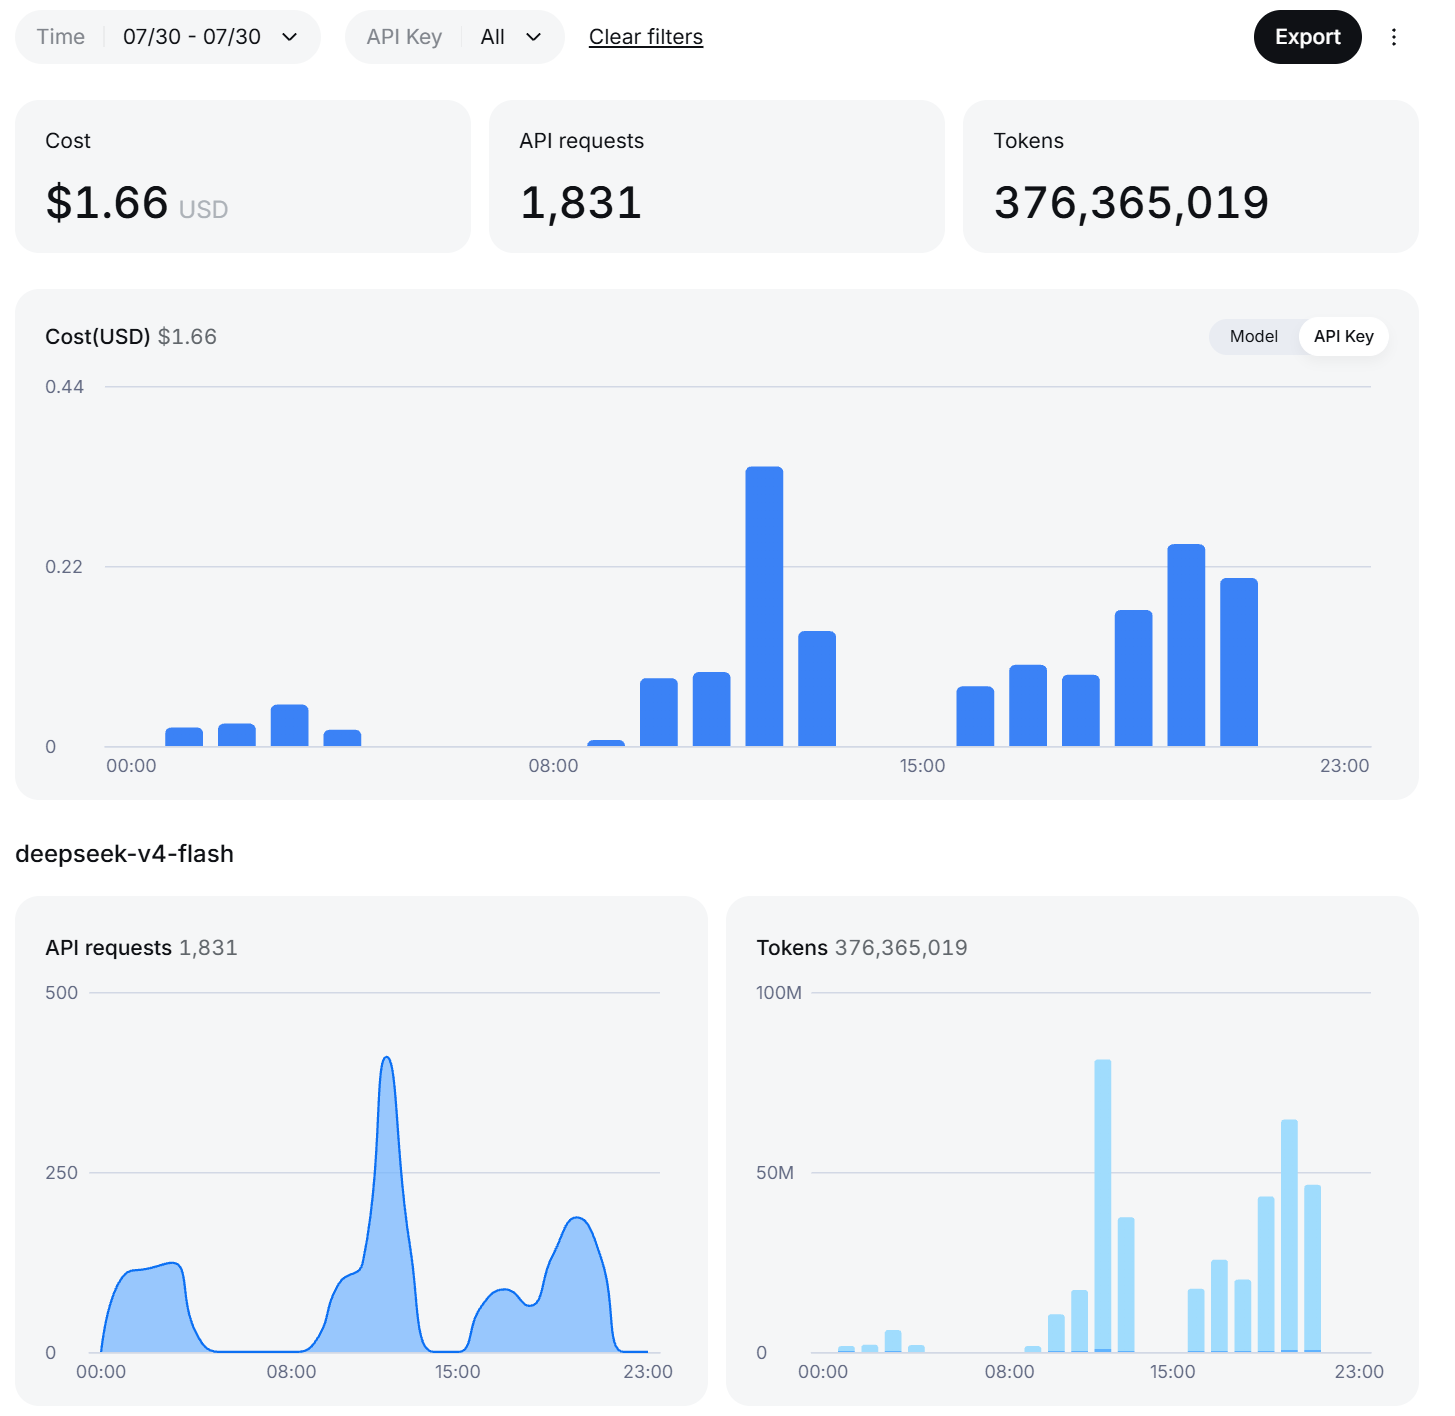
- 結果、1 日で API リクエスト 1,831 回、トークン 376,365,019(約 3.8 億)。お昼前には 1 時間に 400 回ペースで DeepSeek を呼び出す猛ラッシュ。それでもお会計は 1.66 ドル。安い。怖いくらい安い。
- ところが、いったん動いても、機能を足すたびに DeepSeek が既存の機能をきれいさっぱり消してくる(いわゆるデグレ)。直す→消える→直す→消える、の無限ループ。
- 1 日で飽きました。 ……が、このとき味わった「機能を足すと前の機能が壊れる」問題こそ、のちの AuteDev が テストで守りながら作る仕組みにこだわる原点になったのでした。
2026-08-27(木)
GPU アップグレード。 表向きの理由は「ゲームを快適にしたい」。RTX 5070 から RTX 5070 Ti へ買い替え。フリマサイトで 169,800 円!(このあたりから、どうかしていると我ながら感じ始める)
- しかも同日、「もっと大きい LLM をローカルで動かしてみたい」という欲に抗えず、RTX 5060 Ti 16GB もお買い上げ。
- 1 日で GPU が 2 枚になりました。ここから先、GPU は雨後の筍のように増えていきます。
2026-09-03(木)
GPU 追加。 RTX 5060 Ti 16GB を さらに 2 枚。(どうかしてる)
- これで GPU は 4 枚。VRAM が増えるほど、試したいモデルも大きくなっていく。完全に沼の入口です。
2026-09-04(金)
GPU 追加(翌日)。 前日の 2 枚では飽き足らず、RTX 5060 Ti 16GB を さらに 1 枚。(いかれてる)
- 5070 Ti 1 枚 + 5060 Ti 4 枚、合計 5 枚。ただし、この時点ではまだ 5 枚を挿せる PC がありません。順番がおかしい。
2026-09-06(日)
転機。 「GPU をいくら増やしても、作らせる相手が DeepSeek じゃなぁ……」と悩んでいたところ、メールか何かで ChatGPT Plus が 1 か月無料で使えると知り、即契約。
- 7/30 のデグレ地獄の雪辱を果たすべく、今度はもっと賢い相棒と組むことに。
- ChatGPT とあれこれ相談するうちに、いまの AuteDev の構想がぼんやりと固まってくる。 賢い AI には「作る仕組み」を作ってもらい、実際にアプリを作るのは手元のローカル LLM たち——そんな役割分担のイメージが見えてきた日。
2026-09-08(火)
PC ケース交換、そして 80GB 要塞の完成。 GPU 5 枚を収めるため、ケースを大型の LIAN LI O11D EVO XL に交換。届いた箱を見て、でかすぎてびっくり。
- マザーボードは、サーバー用には手が出ないし、ゲームにも使う PC なので、以前からの ASRock B760 Pro RS/D4 WiFi を続投。
- 当然 PCIe スロットは足りません。そこで各種ライザーケーブルを駆使し、帯域が狭くなるのは承知の上で GPU 5 枚をぶっこむ。VRAM 80GB 環境、完成。
- ここから ChatGPT に AuteDev を作らせ、ローカル LLM でテストする日々がスタート。
- ……が、ChatGPT はすぐに利用上限に到達。同日、Claude Pro も契約。プログラムを実行して、失敗して、直して、また実行する——長い日々の幕開けです。